Interview24. September 2026RimparSoftware und Games

Wir verkaufen weniger Umsetzung und mehr Urteil

Daniel Werner von Webfeinschliff über KI in der Softwareentwicklung, neue Fehlerbilder und die wachsende Verantwortung für Betrieb und Sicherheit.

Daniel Werner von Webfeinschliff in Rimpar bei Würzburg baut unter anderem die Recruiting-Plattform HR Rocket mit KI-Werkzeugen. Im Interview erläutert er, welche Entwicklungsaufgaben heute deutlich schneller erledigt werden, warum neue Fehler oft schwerer zu erkennen sind und warum der Aufwand für Prüfung, Sicherheit und Betrieb nicht im gleichen Maße sinkt.

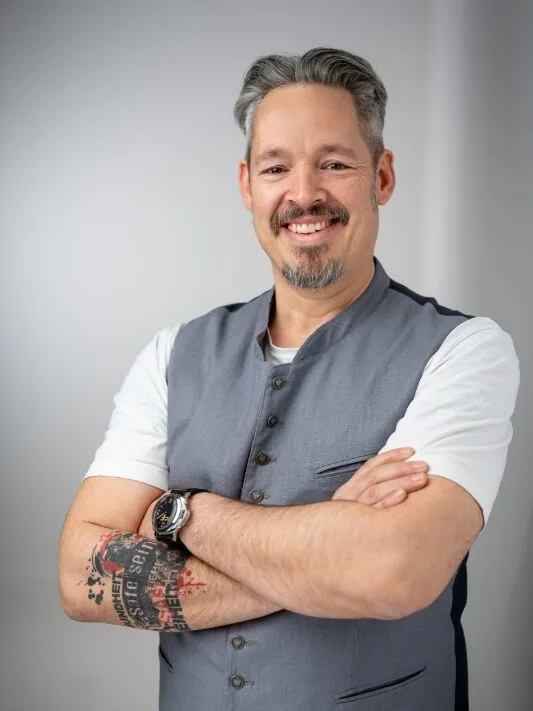
Daniel Werner, Inhaber von Webfeinschliff.
Foto: Werbeagentur Webfeinschliff
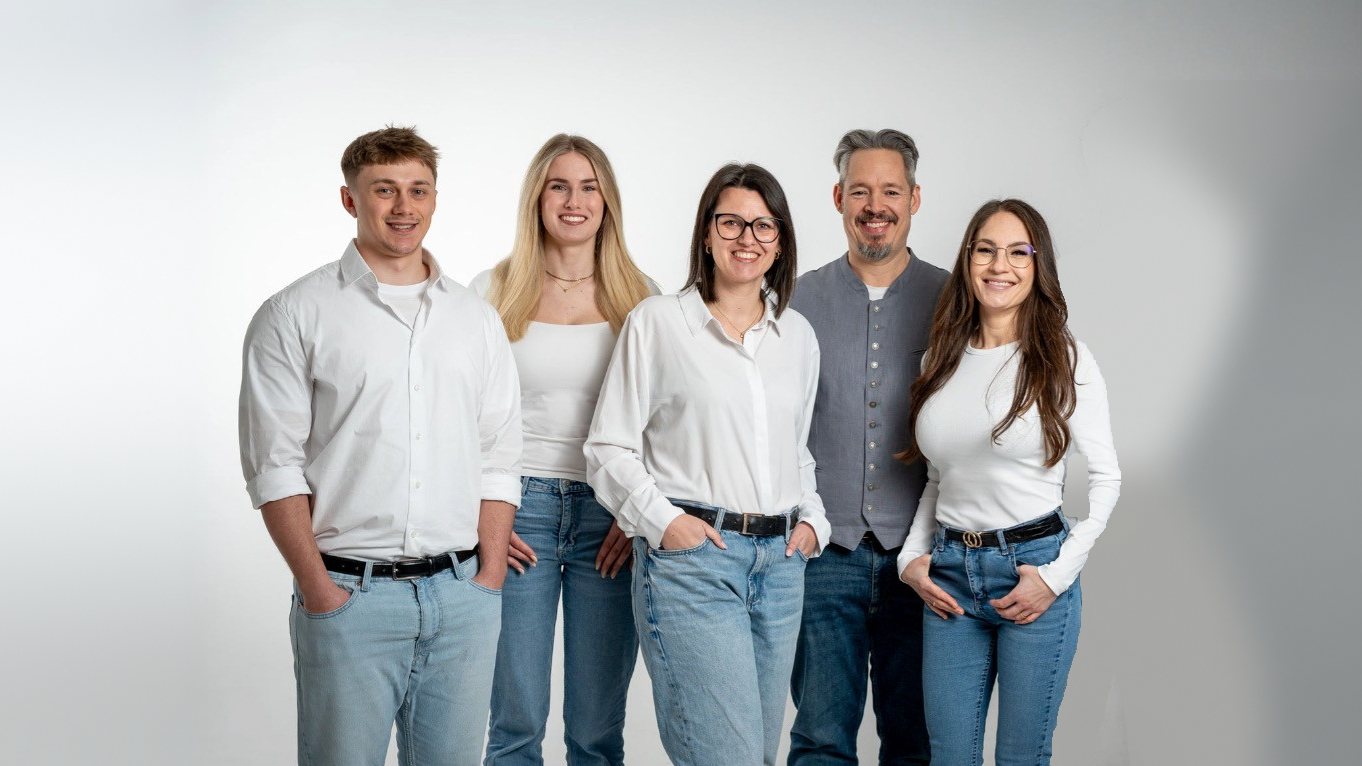
Team von Webfeinschliff in Würzburg.
Foto: Werbeagentur Webfeinschliff
Wir verkaufen weniger Umsetzung und mehr Urteil.

Das Interview

1
Frage der KulturGilde

Sie bauen mit HR Rocket ein System neu auf, in dessen bisherige Entwicklung nach Ihren Angaben mehr als 500.000 Euro geflossen sind. Was hat sich durch Claude Code und andere KI-Werkzeuge beim tatsächlichen Entwicklungsaufwand verändert?

Antwort · Daniel Werner

Die ehrliche Antwort zuerst: Der Flaschenhals war nie das Tippen. Deshalb ist auch nichts um den Faktor zehn schneller geworden. Was sich verändert hat, ist etwas anderes und aus meiner Sicht Wichtigeres.

Deutlich schneller geworden sind bei uns vier Dinge. Erstens Erstfassungen, also der Weg von der leeren Datei zu etwas Lauffähigem. Zweitens alles Repetitive über viele Dateien hinweg: Umbenennungen, Migrationen, dieselbe Anpassung an hundert Stellen. Drittens das Einarbeiten in fremden oder alten Code. Wir bauen ein System neu auf, in dessen Vorgänger nach unserer eigenen Rechnung mehr als 500.000 Euro geflossen sind, und ein großer Teil davon ist Code, den heute niemand mehr im Kopf hat. Früher hieß das: tagelang lesen. Heute ist die erste Orientierung eine Frage von Minuten. Viertens Werkzeuge für den Eigenbedarf, also Skripte, Auswertungen, Prüfungen.

Der vierte Punkt ist der wirtschaftlich interessanteste, weil er neu ist. Wir betreiben heute eine nächtliche Überwachung, die 42 Einzelpunkte über acht Systeme prüft: Lässt sich überall anmelden, antwortet eine falsche Anmeldung korrekt mit einer Fehlermeldung statt mit einem Serverfehler, laufen die Hintergrunddienste, stehen die rechtlich vorgeschriebenen Hinweise noch im Text. So etwas hätte früher niemand gebaut. Nicht weil es unbekannt gewesen wäre, sondern weil es sich bei zwei Tagen Aufwand für ein internes Werkzeug schlicht nicht gerechnet hätte. Genau das ist der eigentliche Effekt: Es entsteht jetzt Software, die vorher unter der Wirtschaftlichkeitsschwelle lag.

Genauso lange oder länger dauert alles, was mit echten Daten, echtem Geld und echten Menschen zu tun hat. Eine Datenmigration, ein Bezahlvorgang, eine Löschfunktion, eine Rechteverwaltung. Dort ist der Aufwand nicht das Schreiben, sondern das Absichern, und das ist eher gewachsen. Länger dauert außerdem das Prüfen, dazu gleich mehr. Unter dem Strich ist bei uns keine Zeit verschwunden, sie ist umgezogen: weg vom Erzeugen, hin zum Beurteilen und Absichern. Meine Größenordnung: Bei Standardaufgaben schaffen wir heute an einem Tag, wofür wir früher 5-10 Tage gebraucht hätten. Bei allem, was in den Betrieb geht, liegt der Gewinn eher bei einem Drittel als bei der Hälfte.
2
Frage der KulturGilde

KI kann heute große Teile des eigentlichen Programmierens übernehmen. Verschiebt sich damit die entscheidende Arbeit vom Schreiben des Codes hin zu dessen Bewertung – und was bedeutet das konkret im Entwicklungsalltag?

Antwort · Daniel Werner

Ja, der Engpass hat sich verschoben, und das ist keine Floskel. Der Unterschied im Alltag lässt sich an einem Satz festmachen: KI liefert zuverlässig eine Lösung, die funktioniert. Die Frage, die sie nicht beantwortet, lautet, ob diese Lösung in einem Jahr noch trägt.

Konkret muss ein erfahrener Entwickler nach jeder erzeugten Änderung mindestens vier Dinge entscheiden. Gehört das an diese Stelle im System oder nur zufällig dorthin, wo gerade gearbeitet wurde? Gibt es das schon einmal, an anderer Stelle, unter anderem Namen? Was passiert beim zehnten Mal, also bei zehnfacher Datenmenge, zehn gleichzeitigen Nutzern, zehn ähnlichen Fällen? Und wer räumt das wieder auf, wenn wir es in zwei Jahren nicht mehr brauchen?

Der zweite Punkt ist der teuerste. KI kopiert bereitwillig, weil Kopieren im Moment der Entstehung die schnellere und risikoärmere Antwort ist. Bei uns gibt es einen Anzeigengenerator zweimal, in zwei getrennten Codebasen. Von 34 gemeinsamen Dateien sind noch acht identisch. Jede Änderung an der Textausgabe müssen wir seitdem an zwei Stellen machen, und jedes Mal, wenn das jemand vergisst, kommt derselbe Fehler an einer Stelle zurück. Diese Aufspaltung ist damals bewusst gefallen, aber sie zeigt das Muster: Duplikate entstehen mit KI schneller, und die Rechnung kommt später.

Woran erkennt man, ob etwas trägt? Ich habe dafür keine Checkliste, sondern drei Fragen. Kann ich in zwei Sätzen erklären, warum es so und nicht anders gebaut ist? Wenn nicht, ist es wahrscheinlich zufällig so. Kann jemand anderes aus dem Team es ändern, ohne mich zu fragen? Und lässt es sich messen, gibt es also einen Weg festzustellen, ob es noch tut was es soll, ohne dass ein Mensch hinsieht?

Wichtiger geworden sind damit Fähigkeiten, die man früher beim Programmieren nebenbei mitgelernt hat: Systemdenken, ein sauberes Datenmodell, Verständnis für den Betrieb. Dazu eine, die kaum jemand so nennt: Anforderungen so zu formulieren, dass die Antwort überprüfbar wird. Und das ist gleichzeitig die unbequeme Nachricht. Beurteilen lernt man nur, indem man selbst lange genug gebaut hat. Wenn die Aufgaben verschwinden, an denen man das früher gelernt hat, verschwindet der Nachwuchs für diese Rolle gleich mit. Das ist aus meiner Sicht das größte ungelöste Problem der Branche, größer als die Frage, ob KI Programmierer ersetzt.

3
Frage der KulturGilde

Welche neuen Fehlerbilder entstehen durch KI-gestützte Entwicklung – und welche klassischen Fehler werden möglicherweise seltener?

Antwort · Daniel Werner

Der Kern in einem Satz: KI-Code sieht richtiger aus, als er ist. Früher sah schlechter Code schlecht aus. Heute ist er sauber formatiert, sinnvoll benannt, kommentiert, und trotzdem falsch. Das verschiebt die ganze Qualitätssicherung, weil der erste Eindruck nicht mehr warnt.

Vier Fehlerbilder sehen wir regelmäßig, alle vier sind in dieser Häufigkeit neu.

Erstens Erfundenes, das plausibel ist. Telefonnummern, Registernummern, Kennzahlen, Kundenstimmen, Quellenangaben. Eine KI, die einen Platzhalter braucht, erfindet einen, der realistisch aussieht. Kein technischer Test schlägt dabei an, denn Tests prüfen die Form, nicht die Wahrheit. Wir haben das mehrfach erst gefunden, als jemand einen Text tatsächlich gelesen hat.

Zweitens der Fehler ohne Symptom. Unser deutlichstes Beispiel: Eine unserer Anwendungen antwortete auf jeder Adresse korrekt, sah im Browser richtig aus, rankte bei Google unverändert gut, und war für die Crawler der KI-Suchmaschinen trotzdem vollständig leer. Nicht schlecht dargestellt, sondern null Zeichen Text. Gefunden hat das keine Prüfung, sondern die Frage, warum ChatGPT uns nicht kennt. Ein Fehler ohne Symptom bleibt liegen, bis jemand gezielt danach sucht.

Drittens Annahmen, die als Liste erstarren. Ein Auslieferungsskript sollte bestimmte Dateitypen hochladen und tat das jahrelang zuverlässig. Dann erzeugte das Bauwerkzeug eine Datei mit einer neuen Endung, und genau diese eine blieb liegen. 150 von 151 Dateien gingen hoch, die Anwendung antwortete weiterhin einwandfrei, und eine Funktion war über Monate tot, ohne dass es sichtbar wurde. Solche Listen entstehen mit KI besonders leicht, weil eine Aufzählung im Moment des Schreibens die exakteste Antwort ist.

Viertens, und das ist die unangenehmste Kategorie: Die Prüfung ist selbst Software und selbst falsch. Unsere nächtliche Überwachung meldete an einem Morgen vier rote Fehler, die sie selbst erzeugt hatte, weil sie zu schnell und unter einer ungeeigneten Kennung gemessen hatte. Die Systeme waren in Ordnung. Ein Alarm, der ohne Grund rot wird, wird nach zwei Wochen nicht mehr gelesen, und dann fällt der Tag nicht auf, an dem er stimmt. Wir haben deshalb drei Stufen eingeführt: grün, rot, und dazwischen gelb für nicht messbar. Der Unterschied zwischen „es ist kaputt" und „wir konnten es nicht prüfen" ist wichtiger, als er klingt.

Deutlich seltener geworden sind dafür die klassischen Fehler: Tippfehler, vergessene Sonderfälle, fehlende Fehlerbehandlung, unbehandelte Leerwerte, schlampiger Standardcode. Da ist die Qualität objektiv gestiegen, und zwar spürbar. Auch Code, den früher niemand kommentiert hat, ist heute besser dokumentiert als je zuvor.

Für unsere Qualitätssicherung heißt das: Wir prüfen weniger, ob etwas läuft, und mehr, ob etwas stimmt. Und wir messen von außen, mit denselben Werkzeugen, mit denen ein Nutzer oder eine Suchmaschine auf das System schaut, statt uns auf grüne Tests zu verlassen. Ein grüner Test ist eine Aussage über den Code. Er ist keine Aussage über die Wirklichkeit.

4
Frage der KulturGilde

Wie verändern KI-Werkzeuge Testing, Dokumentation und Sicherheit?

Antwort · Daniel Werner

Beim Testen ist der Gewinn groß und die Falle konkret: KI schreibt bereitwillig Tests, aber sie schreibt Tests, die den Code bestätigen, den sie gerade selbst geschrieben hat. Damit ist ein Denkfehler nicht gefunden, er ist doppelt vorhanden. Testfälle müssen aus der Anforderung kommen, nicht aus dem Code. Das ist Handarbeit und bleibt es. Hervorragend delegierbar sind dagegen die Ausführung, die Abdeckung der langweiligen Fälle und das Nachziehen von Tests nach Umbenennungen. Ein Befund, den wir erst durch KI klar formulieren konnten: Manchmal fehlt nicht ein Test, sondern die Möglichkeit, einen zu schreiben. Dann ist der Bauplan das Problem, nicht die Testabdeckung.

Dokumentation ist der unstrittigste Gewinn von allen. Sie war immer das, was als Erstes wegfiel, weil sie niemand bezahlt. Heute entsteht sie nebenbei und ist besser als das, was wir früher von Hand geschrieben haben. Eine Einschränkung gilt trotzdem: Dokumentation ist eine Behauptung über einen Zustand, keine Messung. Bei uns stand einmal schwarz auf weiß, ein Bereich sei mit einem Passwortschutz abgesichert. Er war es nie. Wir schreiben deshalb inzwischen dazu, was wann gemessen wurde, nicht nur, wie es gedacht ist.

Zur Sicherheit, wie besprochen als Muster. Fünf Risiken sollte jedes Unternehmen kennen, bevor es KI-erzeugten Code produktiv nimmt.

Die fehlende Zugriffsprüfung ist mit Abstand das häufigste. KI baut eine Funktion, die Dateien entgegennimmt und wieder ausliefert, und sie tut das korrekt. Was regelmäßig fehlt, ist die Prüfung, wer da eigentlich fragt. Ein schwer zu erratender Dateiname ist kein Zugriffsschutz, er fühlt sich nur so an. Diese Lücke fällt nie durch einen Fehler auf, denn aus Sicht des Systems funktioniert alles.

Das zweite sind Standardwerte, die für ein Beispiel richtig und für den Betrieb falsch sind: Fehlerausgaben eingeschaltet, großzügige Berechtigungen, weit geöffnete Schnittstellen, Sitzungen die nie ablaufen. In einer Anleitung ist das sinnvoll. Auf einem Produktivsystem ist es eine offene Tür.

Das dritte sind Zugangsdaten, die in Dateien landen, die anschließend in der Versionsverwaltung liegen. Passiert schnell, ist aufwendig zu heilen, weil ein einmal veröffentlichtes Passwort gewechselt und nicht gelöscht werden muss.

Das vierte betrifft Abhängigkeiten. KI schlägt fremde Programmbibliotheken vor, manche veraltet, manche mit bekannten Lücken, und in seltenen Fällen welche, die es gar nicht gibt. Der letzte Fall ist gefährlich, weil Angreifer inzwischen gezielt Pakete unter solchen erfundenen Namen veröffentlichen.

Das fünfte ist kein Programmierfehler, sondern eine Frage der Vertragsgestaltung, und es wird am häufigsten übersehen: welcher KI-Anbieter, welcher Tarif, welche Daten. Bei mehreren großen Anbietern darf im kostenlosen Tarif mit den übermittelten Inhalten gearbeitet werden, teilweise sehen Menschen Stichproben. Wer dort personenbezogene Daten hindurchschickt, hat einen Datenschutzvorfall, ohne dass eine einzige Zeile Code falsch wäre. Wir haben deshalb bei jedem unserer KI-Dienste geprüft und dokumentiert, dass er im bezahlten Tarif läuft, und einen Auftragsverarbeitungsvertrag nach Artikel 28 DSGVO geschlossen. Dazu kommt die Kennzeichnungspflicht aus Artikel 50 der KI-Verordnung, die seit dem 2. August 2026 gilt: Ein KI-Dialog muss sich als solcher zu erkennen geben, und zwar vor der ersten Nutzung, nicht irgendwo in der Datenschutzerklärung.

Unverzichtbar menschlich bleibt alles, wo Geld, Rechte oder personenbezogene Daten hängen: Berechtigungen, Bezahlvorgänge, Löschungen, Datenmigrationen und jede Änderung an einer Datenbank, in der schon Kundendaten liegen.

5
Frage der KulturGilde

Wenn kleine Teams mit KI heute Entwicklungsleistungen bewältigen können, für die früher deutlich größere Mannschaften nötig waren: Was verändert das wirtschaftlich im Softwaremarkt?

Antwort · Daniel Werner

Der Effekt ist aus meiner Sicht nicht „weniger Entwickler", sondern „mehr Software". Wenn etwas billiger wird, wird mehr davon gebaut. Wir sind selbst das Beispiel: Wir stemmen mit einem kleinen festen Team eine Produktlast, für die früher eine ganz andere Mannschaft nötig gewesen wäre.

Für kleine Agenturen und Softwareunternehmen ist die Chance real, aber sie hat eine Kehrseite, die in der Diskussion fast nie vorkommt. Der Aufwand verschwindet nicht, er wandert vom Bauen in den Betrieb. Mehr Software heißt mehr Wartung, mehr Angriffsfläche, mehr Abhängigkeiten, mehr laufende Kosten. Wer nur für Kunden baut, merkt das kaum, weil er das gebaute System nicht selbst bezahlt. Wir betreiben unsere eigenen Produkte und sehen die Rechnung jeden Monat. Meine Einschätzung: Die Baukosten sind spürbar gesunken, die Betriebskosten pro System nicht.

Bei den Preisen gerät die reine Aufwandsabrechnung unter Druck, und zwar zu Recht. Wer nach Stunden abrechnet, verkauft künftig weniger Stunden für dasselbe Ergebnis und muss entweder den Stundensatz erhöhen oder das Modell wechseln. Wer nach Ergebnis und Verantwortung abrechnet, hat das Problem nicht. Bezahlt wird ohnehin nicht das Tippen, sondern die Zusage, dass es morgen noch läuft und dass jemand geradesteht, wenn nicht.

Bei Make or buy sinkt die Schwelle für „selbst bauen" deutlich, und viele Unternehmen werden das tun. Mein Rat dazu ist unbequem: Die Entscheidung fällt beim Bauen, die Kosten fallen beim Betreiben. Ein selbst gebautes System, das niemand pflegt, ist nach drei Jahren teurer als jede Mietlösung, nur zahlt man dann nicht in Rechnungen, sondern in Ausfällen.

Die Rollenverteilung zwischen Auftraggeber und Dienstleister verschiebt sich ebenfalls. Kunden kommen inzwischen mit einem selbst gebauten Prototypen ins Gespräch. Das ist gut, das macht die Gespräche konkreter und ehrlicher. Was der Auftraggeber nicht selbst kann, ist beurteilen, ob das Ding trägt, und genau dort liegt künftig die Wertschöpfung des Dienstleisters. Wir verkaufen weniger Umsetzung und mehr Urteil.

An Wert gewinnen damit: Anforderungen sauber formulieren, Architektur, Betrieb, Sicherheit und Datenschutz, systematisches Prüfen und Messen, und Fachwissen über die Branche des Kunden. An Wert verliert im Wesentlichen eines, nämlich Syntax auswendig zu können.

6
Frage der KulturGilde

Welche falschen Erwartungen begegnen Ihnen derzeit bei Kunden oder Interessenten, wenn es um KI-gestützte Entwicklung geht – und woran erkennt ein Auftraggeber, ob eine Agentur KI tatsächlich professionell einsetzt oder lediglich schneller Code erzeugt?

Antwort · Daniel Werner

Drei Erwartungen begegnen mir immer wieder.

„Dann geht das ja in einem Tag." Der Prototyp geht in einem Tag, manchmal in einer Stunde. Der Unterschied zwischen einem Prototypen und etwas, das mit echten Nutzern, echten Daten und echtem Geld läuft, ist der eigentliche Aufwand, und der ist nicht kleiner geworden. Er ist nur weniger sichtbar als früher, weil der Prototyp so gut aussieht.

„Dann kostet das ja nichts mehr." Der Anteil des reinen Programmierens am Preis war schon früher kleiner, als die meisten denken. Konzept, Abstimmung, Test, Betrieb und Verantwortung waren immer der größere Teil.

„KI prüft sich selbst." Tut sie nicht. Sie bestätigt sich selbst, und das ist etwas anderes.

Für die Auswahl eines Dienstleisters würde ich Unternehmen sechs Fragen empfehlen. Erstens: Wie stellen Sie fest, dass eine Änderung tatsächlich live angekommen ist? Eine gute Antwort beschreibt eine Messung, eine schlechte beschreibt einen Prozess. Zweitens: Nennen Sie mir einen Fehler, der Ihnen mit KI passiert ist, und was Sie danach geändert haben. Wer keinen nennen kann, hat entweder wenig gemacht oder wenig geprüft. Drittens: Was überwacht Ihre Software, wenn niemand hinsieht? Viertens: Welchen KI-Anbieter nutzen Sie, in welchem Tarif, und liegt ein Auftragsverarbeitungsvertrag vor? Fünftens: Wo kennzeichnen Sie KI, und warum genau dort? Sechstens: Bekomme ich Quellcode und alle Zugänge? Wer Software in einem Werkzeug baut, aus dem man nicht wieder herauskommt, verkauft eine Abhängigkeit.

Warnsignale gibt es vier, die ich ernst nehmen würde. Wenn Geschwindigkeit das Hauptargument im Verkaufsgespräch ist, wird die Rechnung im Betrieb präsentiert. Wenn ein Festpreis ohne Rückfragen kommt, hat niemand verstanden, was gebaut werden soll. Wenn „wir arbeiten mit KI" als Leistungsmerkmal verkauft wird statt als Werkzeug, ist es Marketing. Und wenn zu Wartung, Betrieb und Übergabe nichts im Angebot steht, sind genau das die Posten, die später dazukommen.

Ein letzter Punkt, der zu Ihrer Leserschaft passt. Man erkennt KI-erzeugte Inhalte, und Kunden erkennen sie auch. Bei uns gilt deshalb eine harte Regel für alle Texte, die ein Mensch liest, samt Liste der typischen Formulierungen, die nicht vorkommen dürfen. Das Entscheidende dabei: Diese Regel steht in den Anweisungen an die KI, nicht in einer Nachbearbeitung. Wer nur nachputzt, hat beim nächsten Durchlauf dasselbe Problem. Für Software gilt genau dasselbe: Qualität entsteht in der Vorgabe, nicht in der Korrektur.

Über Webfeinschliff

Webfeinschliff hat seinen Sitz in Rimpar bei Würzburg und arbeitet in den Bereichen Webdesign, Softwareentwicklung, KI und Online-Marketing. Inhaber ist Daniel Werner. Zur Unternehmensgruppe gehört die HR Rocket GmbH, deren Recruiting- und Jobbörsensystem derzeit mit KI-Werkzeugen neu aufgebaut wird.

Mehr zum Thema

Weitere Praxisstimmen

Porträt von Ralph Christian Schneider, dem Entwickler von Musician Trading Cards.Foto: Ralph Christian Schneider
Praxisstimme

MusikwirtschaftNürnberg

Musikgeschichte zum Sammeln: Wie Musician Trading Cards Musik neu erlebbar machen

Ralph Christian Schneider entwickelt in Nürnberg ein Sammelkartenkonzept, das Musikvermittlung, Gestaltung und digitale Inhalte miteinander verbindet. Mit Musician Trading Cards (MTC) sollen Menschen Musiker, Komponisten und Musikrichtungen entdecken – von der physischen Karte bis zum unmittelbaren Hörerlebnis über das Smartphone.

Ralph Christian Schneider · MTC – Musician Trading Cards · Nürnberg

Praxisstimme lesen
Julian Lindner (links) und Stefan Schröder von Everplay Studio mit ihrem Brettspiel Ghosttown.© Julian Lindner / Everplay Studio
Praxisstimme

Software und GamesBindlach

Ein Brettspiel besteht nicht nur aus einer guten Spielidee

Everplay Studio entwickelt in Bindlach das strategische Brettspiel Ghosttown. Das unabhängige Team berichtet, wie Spielmechanik, Illustration, Produktion und Finanzierung zusammenhängen, warum Community-Feedback die Entwicklung verbessert und welche Herausforderungen kleine Spieleentwickler auf dem Weg zur Veröffentlichung bewältigen müssen.

Julian Lindner und Stefan Schröder · Everplay Studio · Bindlach

Praxisstimme lesen
Praxisstimme

WerbemarktFeucht

KI-generierte Entwürfe im Agenturalltag: Wo KI hilft – und wo neue Arbeit entsteht

Thomas Schachner von der zeitstopp OHG beschreibt, wie KI-generierte Texte, Bilder und Gestaltungsideen inzwischen im Agenturalltag ankommen. Sie können eine sinnvolle Ausgangsbasis sein. Gleichzeitig zeigt die Praxis, dass vermeintlich fertige Ergebnisse häufig Beratung, Korrektur und professionelle technische Umsetzung benötigen.

Thomas Schachner · zeitstopp OHG · Feucht

Praxisstimme lesen